Saltar al contenido →

Año: 2026

Poneos en guardia, cada libro es una batalla

Es así de crudo, la IA es inevitable así como su impacto. Su influencia ya se extiende de forma mucho más rápida que cualquier invención que haya desplegado la Humanidad a lo largo de su historia. Y aunque su adopción haya sido rápida, todavía no somos del todo conscientes hasta dónde llegan o pueden llegar sus raíces para transformarnos a todos.

Es cierto, lo intuimos, sí, es un olor muy suave, muy sutil. Acaba de llegar y ya lo identificamos. Lo impregna todo. Lo vemos en nuestros quehaceres diarios, en las decisiones que tomamos, las influencias que recibimos, en cada una de las valoraciones de cada producto o servicio que consumimos. Sentimos que nos sentamos al borde de la la disrupción, pero no sentimos que la IA sea un término que nos quieren imponer como sucedió antes. Es algo más próximo, más cercano, algo que ya tocamos y sentimos casi todos los días.

De momento, todo tiene un precio. La rápida asimilación provoca un empacho y saturación. Una marquesina del transporte público que nos genera rechazo, una publicidad animada en las redes sociales con imágenes plastificadas que nos resulta irreal y nos saca del mensaje que nos querían inocular. Unas personas aparentemente exitosas, sanas, atléticas y bellas que nos parecen casi irreales por ser demasiado perfectas, demasiado resolutivas e ingeniosas -aunque demasiado iguales-. Como en la película El Show de Truman, todo es o demasiado impostado o demasiado perfecto y como en la película no podemos seguir asimilándolo.

Esta es la pregunta a la que llegaremos finalmente: ¿cuándo lo humano se convirtió en digital y cuándo el ser humano prefirió la frialdad del bit frente a la imperfección inherente de las células. Es fácil ser pesimista. Hay muchas reflexiones sobre un futuro distópico en el que el humano es sustituido por máquinas. Aunque si queremos huir de lo más siniestro podríamos acudir a la película Her donde las relaciones humanas auténticas son sustituidas por las conversaciones con un asistente de voz (agente también lo llamarían hoy en día en la jerga) que trata de satisfacer por todos los medios a su humano. Esto llega a tal extremo que el protagonista lo rechaza porque considera que hay ciertos límites que no se pueden rebasar. Pero, ¿en todos los casos?

Malas noticias, es una batalla perdida. La fotografía ya descubrió sus hechuras cuando la IA solo se ensayaba en 2023. Ahora lo más humano, lo que nos permitió avanzar como civilización y ser menos animales: la transmisión de conocimiento mediante la palabra escrita también se encuentra asaltada. En cualquier caso, no deberíamos preocuparnos. Si el algoritmo nos genera un problema y utilizamos otro para tratar de resolverlo. Una escalada matemática que solo puede llevarnos a decepciones, puesto que tiene fallos e incluso la IA puede impostar un estilo para parecer más «humano.»

Sin embargo, si vamos con el ojo avizor, es un viaje apasionante. Todos los humanos somos puestos frente a un espejo, puesto que aquello que nos definió como la literatura, el arte, la cultura y el conocimiento puede ser generado con una frase, unos comandos y cierta capacidad de cómputo. ¿Seremos capaces de enfrentarnos al desafío de aceptar lo que nos hace realmente humanos o preferiremos solo una síntesis de todo aquello que podríamos ser?

Deja un comentario
Con la IA, nos inundamos de newsletters

Hace unos años, tratar de determinar la señal del ruido requería un alto esfuerzo intelectual (y de tiempo) de analistas que debían estar escaneando las actualizaciones frecuentes de los sistemas de vigilancia que tenían implementados en sus organizaciones. Para este proceso, había distintas aproximaciones y con cierto grado de automatización, desde el repaso diario de los principales medios hasta la incorporación de los temas candentes en bases de datos.

No es sorprendente afirmar que hoy en día, el procesado de esta información se puede simplificar mucho gracias a la utilización de las habilidades que ofrece la inteligencia artificial que, usada con cautela, puede servir de apoyo a la hora de destilar las principales noticias de interés dentro de los ecosistemas de información de cada sector.

Por supuesto que empresas especialistas en gestión de la información y del conocimiento, incluso algunas más alejadas con distintos alcances y productos, ofrecen herramientas apoyadas en la IA para digerir todo el conocimiento que se genera día a día dentro de un sector. Uno de los productos informativos que más se está aplicando la IA para su confección son las newsletters. Podemos afirmar que este es uno de los productos más directo, ya que incluso los creadores de contenido de Internet se apoyan en ellas para actualizarse y mantener informada a su audiencia. Sin embargo, me sorprende en ocasiones recibir newsletters automáticas sobre las que no se ha reflexionado en exceso y que se envían a veces de manera un tanto indiscriminada y que tienen el efecto contrario de lo que se quiere obtener.

Tal vez haya que aclarar que una newsletter no es un correo masivo enviado de forma indiscriminada (lo que caería dentro de la categoría de spam). Una newsletter es una publicación periódica destinada a una persona que decidió recibirla. Por supuesto, que hay muchos usos y tipos de ellas, con distintos alcances, pero deben incluir contenido relevante ya sea informativo o comercial para fortalecer la relación con la audiencia o con los clientes. Aquí ya encontramos su primera ventaja, puesto que se establece una comunicación personalizada y frecuente con los lectores que constituyen un tráfico cualificado puesto que demostraron interés en recibirla. Esto sirve de palanca para poder establecer una serie de métricas claras como tasa de apertura, clics sobre contenido y tasas de conversión en el caso de que se promocione un producto y servicio. Como contraparte, también puede generarse una sobresaturación de correos lo que puede provocar que la newsletter sea ignorada y peor calificada como spam. Esto puede caer tanto de parte del emisor (demasiados correos) como del receptor (demasiadas suscripciones).

La newsletter debe tener establecido un objetivo claro como fidelizar clientes, generar tráfico hacia nuestra web, posicionar una marca o un producto, la generación de tráfico cualificado hacia redes sociales (calls to action). Por ello, también es importante definir el tipo de contenido, el tono y la frecuencia del envío.

En el caso del análisis de información, una newsletter no debe ser genérica. No es suficiente, ni debemos conformarnos, con lo que es capaz de ofrecer un sistema de grandes modelos de lenguaje, sino que debe establecerse una serie de bloques o preguntas que debemos despejar y que hacen referencia en lo citado anteriormente. En primer lugar, sobre qué fuentes se debe construir esa newsletter (¿es una newsletter sobre mercado? ¿tecnológica? ¿de I+D?), en segundo lugar considerar el público objetivo de esa newsletter (¿a qué departamento o área pertenecen?) y establecer una serie de elementos de feedback (¿Me interesa? ¿Quiero más información?); sin olvidar que qué queremos obtener con esta newsletter. Debemos siempre tener presente que si la newsletter no aporta valor al destinatario acabará en la carpeta de spam. Por ello, tenemos que revisar siempre lo que enviamos y desconfiar en los automatismos. Además hay que tener presente que la IA suele ser “perezosa” en algunas ocasiones y sólo llega hasta cierto nivel de esfuerzo por lo que no es suficiente sólo con generar una newsletter si no que hay que revisar los contenidos, reescribirlos si fuese necesario e incorporar otros no detectados y aquí entrarían nuestro conocimiento como analistas.

Deja un comentario

Gafas inteligentes y un nuevo contrato social

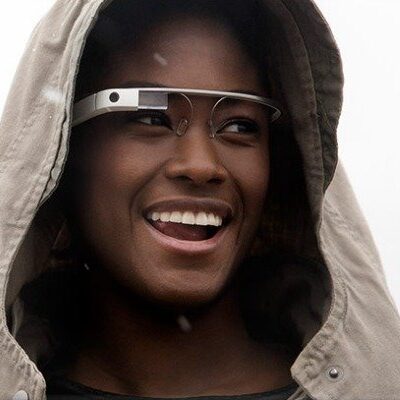
El hombre es el único animal capaz de tropezar dos veces con la misma piedra. En este caso, son las tecnológicas. En 2014, la gran G lanzó las Google Glass (con un precio de $1500). Un dispositivo que afirmaba dar un paso más hacia la computación ubicua y que no se parecía a unas gafas al uso. A simple vista, se detectaba a sus usuarios puesto que se distinguía la cámara y una pequeña pantalla donde se mostraba información.

Imagen Promocional Google Glass (2014)

Estas primeras gafas inteligentes disponían de una interfaz de control mediante gestos, una cámara que era capaz de tomar fotografías y vídeos en alta resolución (720p) y una pantalla que mostraba información. Las gafas permitían consultar Gmail o Google Maps, pero se le fueron añadiendo otras capas como el reconocimiento facial, interacción con redes sociales, ejercicio o traducción.

El dispositivo prometía un nuevo segmento dentro de los wearables, pero pronto se acuñó un nuevo término para designar a sus usuarios «glassholes.» – derivación del inglés assholes.- La preocupación sobre la captura de imágenes o audios no consentidos fue en aumento, así como su utilización para el reconocimiento facial en la vía pública. Las administraciones públicas, cines o casinos comenzaron a restringir el acceso a sus instalaciones con usuarios con estos dispositivos, no sólo por la grabación no consentida sino también por amenazas de ciberseguridad y que fuesen utilizadas por terceros. Google decidió dejar de distribuirlas en 2015, un año después de su lanzamiento.

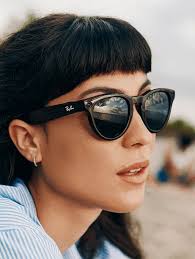
Una década después, Meta lanza una nueva versión de gafas con cámara. Esta iteración del producto viene potenciado por la IA y la miniaturización de los componentes las hace mucho más difíciles de detectar a simple vista. Sin embargo, la situación es similar a la de hace diez años o puede que incluso peor con una mayor capacidad de procesamiento y conectividad. Aunque hubieron lecciones aprendidas en el antecedente incorporando una luz LED cuando el dispositivo está grabando, Meta se enfrenta a un fracaso de sus políticas para tratar de evitar las violaciones de privacidad de los usuarios de sus gafas.

Imagen promocional Meta Glasses (2026)

Las redes sociales y la búsqueda de la viralidad de algunas tipologías de vídeos agravan el problema ya que se difunden rápidamente justamente en Instagram, otra de las plataformas de Meta. En este caso, la definición de sus early adopters es mucho más grave y define un comportamiento mucho más preocupante. Meta prosigue en su exploración de los límites con su ambición de incorporar el reconocimiento facial en sus gafas como haría Google una década antes. Parece que en un futuro deberemos llevar un código QR en la cara para evitar ser grabados e identificados sin nuestro consentimiento por un producto comercial.

Este problema sobre el uso que dan los usuarios a las capacidades tecnológicas de las cámaras no sólo va a ser un reto para la compañía de Zuckerberg, ya que tanto Google como Apple consideran lanzar sus propias versiones de gafas inteligentes antes de que acabe este año.

Deja un comentario

Una gran dislocación cultural

La ciencia ficción nos habló de ella, imaginó múltiples mundos, aunque no nos preparó del todo para lo que realmente llegaría hasta nosotros y sus grandes implicaciones. Como las grandes revoluciones, su impacto se comportó como un tsunami. El agua se retira de forma calmada, generando estupefacción y sorpresa al espectador que la observa con incredulidad. No hace ruido, no hay señales de alarma en un inicio. Todo sucede en aparente silencio, sin grandes estruendos hasta que de súbito una marea parece inundarlo todo.

La inteligencia Artificial para funcionar necesita una cantidad ingente de datos para entrenar sus modelos. Sus necesidades son tan altas que no es suficiente todo el conocimiento generado por la Humanidad a lo largo de su historia para alimentarla y entrenarla, para mejorarla. Hoy, ha llegado al punto en el que necesita que el ser humano le comparta los documentos y las acciones intermedias. Aquellas que sirven para llegar a cierto destino ya sea intelectual como de proceso. Su apetito es tal que es irrefrenable, las expectativas de beneficio son altas que sobre la nueva big-next thing de Silicon Valley se vierten millones, aunque con un coste directo e indirecto que nadie podrá pagar la factura.

Todo empieza con coger lo que queda a mano (move fast, break things). Descargan información de repositorios como LibGen (más de 7 millones de documentos descargados) y páginas web. Cuando aumenta el cierto runrún de lo deshonesto de su acción, ya que es una empresa cuyo fin es el beneficio económico, deciden pagar y adquirir libros – preferiblemente anteriores a 2020 preferiblemente para que no estén contaminados por la IA – para escanearlos masivamente. La utilidad de estos libros finaliza en el momento que se digitalizan y después son destruidos. El libro de segunda mano se beneficia de este pico de demanda, pero estos documentos son sacadas del mercado para no volver. Libros descatalogados reconvertidos en pulpa de papel mientras el conocimiento depositado se pierde irremediablemente entre algoritmos.

Por ese uso no reglado, ni imaginado hace menos de una década, se les piden compensaciones económicas millonarias por su piratería o con acuerdos con medios de comunicación. Ese patrimonio cultural escaneado desaparece de una forma consciente obviando el impacto, mientras que inconscientemente lo hace todo el ecosistema informativo creado en la Web desde los años 90. El tráfico de los sitios web se desploma entre un 15-35% debido a la IA y la transformación del gran distribuidor de clics hasta el momento (Google) en un momento de cambio de la atención y de consumo de información. Pero, al mismo tiempo, la IA necesita de esa información para seguir siendo útil al tiempo que destruye los cimientos sobre los que se ha construido y sobre la que se mantiene útil y relevante. ¿Podrán mantenerse este gigante siendo viable sin los que alimentan sus modelos de negocio?

Deja un comentario